- تجارت فارکس چیست؟راهنمای سریع برای مبتدیان
- ضرر UBS حفره تجارت اروپا را در معرض دید قرار می دهد
- NFT ها در محبوبیت فرو می روند؟بله ، این معنی دارد.
- دوره های آموزشی
- رویکرد ریگاتونی به کشش دو لایه
- در تاریخ طولانی سقوط بازار، سقوط کرونا کوتاهترین زمان بود
- حساب ها را مقایسه کنید
- چرا کورکورانه پیروی از گزینه های معاملات شما در نهایت منجر به شکست می شود
- همبستگی آماری
- الگوی شمع Double Doji: معنی آن چیست؟
آخرین مطالب
امکانات وب


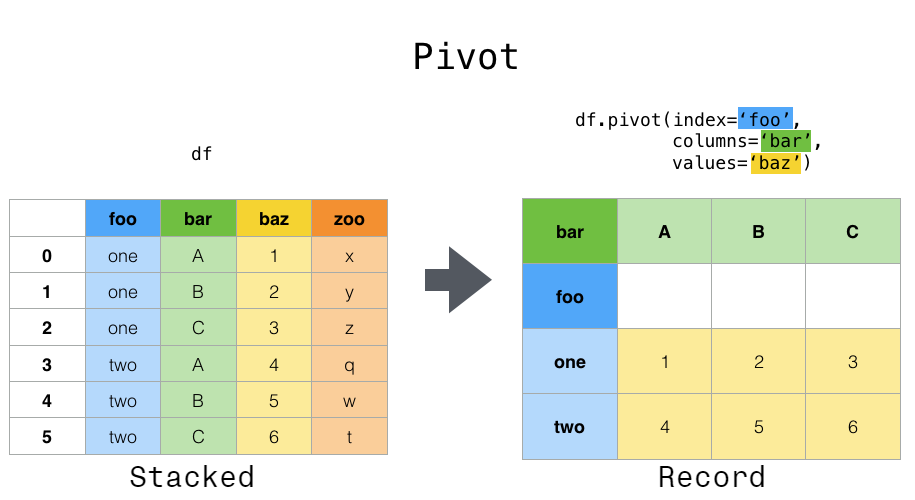
داده ها اغلب در قالب به اصطلاح "انباشته" یا "ضبط" ذخیره می شوند:
برای انتخاب همه چیز برای متغیر A که می توانیم انجام دهیم:
اما فرض کنید ما می خواهیم عملیات سری زمانی را با متغیرها انجام دهیم. نمایندگی بهتر در جایی خواهد بود که ستون ها متغیرهای منحصر به فرد هستند و شاخص تاریخ مشاهدات فردی را مشخص می کند. برای تغییر شکل داده ها به این فرم ، ما از روش dataframe. pivot () استفاده می کنیم (همچنین به عنوان یک محور عملکرد سطح بالا ()) اجرا می شود:
اگر آرگومان مقادیر حذف شده باشد ، و DataFrame ورودی دارای بیش از یک ستون از مقادیر است که به عنوان ورودی ستون یا شاخص به Pivot () استفاده نمی شود ، پس داده های "محوری" حاصل دارای ستون های سلسله مراتبی هستند که بالاترین سطح آن نشان دهنده مقدار مربوطه استستون:
سپس می توانید زیر مجموعه های DataFrame Pivoted را انتخاب کنید:
توجه داشته باشید که این یک دیدگاه در مورد داده های اساسی در مواردی که داده ها به صورت همگن تایپ می شوند ، باز می گردد.
Pivot () با یک ValueError خطا خواهد کرد: شاخص شامل ورودی های تکراری است ، اگر جفت شاخص/ستون منحصر به فرد نباشد ، نمی توانند تغییر شکل دهند. در این حالت ، استفاده از Pivot_Table () را در نظر بگیرید که تعمیم محوری است که می تواند مقادیر تکراری را برای یک جفت شاخص/ستون کنترل کند.
تغییر شکل با انباشت و دفع#
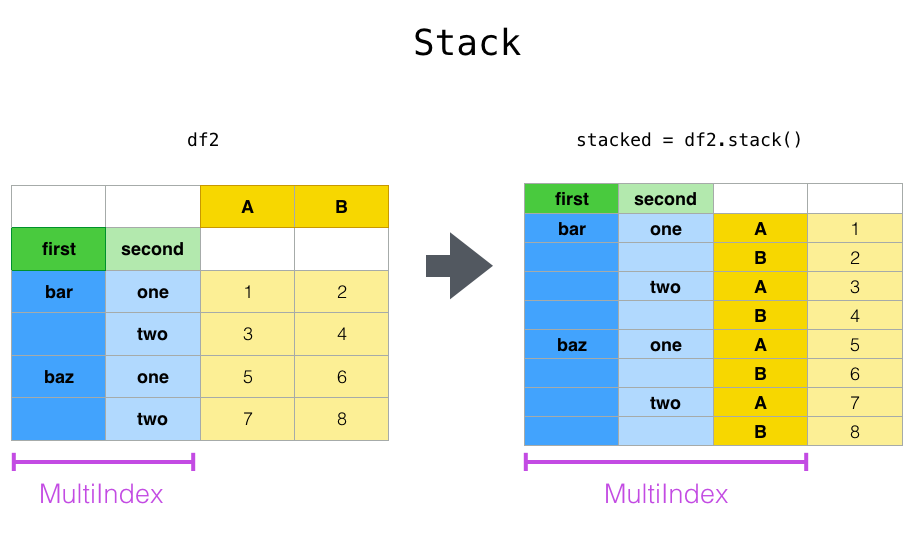
نزدیک به روش Pivot () روشهای مرتبط با پشته () و Unstack () موجود در سری و DataFrame هستند. این روشها برای همکاری با اشیاء MultiIndex طراحی شده اند (به بخش فهرست بندی سلسله مراتبی مراجعه کنید). در اینجا اساساً آنچه این روشها انجام می دهند وجود دارد:
stack (): "محوری" یک سطح از برچسب های ستون (احتمالاً سلسله مراتبی) ، بازگشت یک داده با یک شاخص با یک سطح داخلی جدید برچسب های ردیف.
Unstack (): (عملکرد معکوس پشته ()) "محوری" یک سطح از شاخص ردیف (احتمالاً سلسله مراتبی) به محور ستون ، تولید یک فریم تغییر شکل یافته با یک سطح داخلی جدید از برچسب های ستون.
واضح ترین راه برای توضیح به عنوان مثال است. بیایید مجموعه داده های قبلی را از بخش نمایه سازی سلسله مراتبی بگیریم:
عملکرد پشته () یک سطح را در ستون های DataFrame "فشرده می کند" تا تولید کند:
یک سری ، در مورد یک شاخص ستون ساده.
یک DataFrame ، در مورد چند خط در ستون ها.
اگر ستون ها دارای یک چندگانه هستند ، می توانید کدام سطح را برای پشته انتخاب کنید. سطح انباشته شده به پایین ترین سطح جدید در یک مولتی در ستون ها تبدیل می شود:
با داشتن یک داده یا سریال "انباشته" (داشتن یک فهرست چندگانه به عنوان شاخص) ، عملکرد معکوس پشته () Unstack () است ، که به طور پیش فرض آخرین سطح را برآورده می کند:
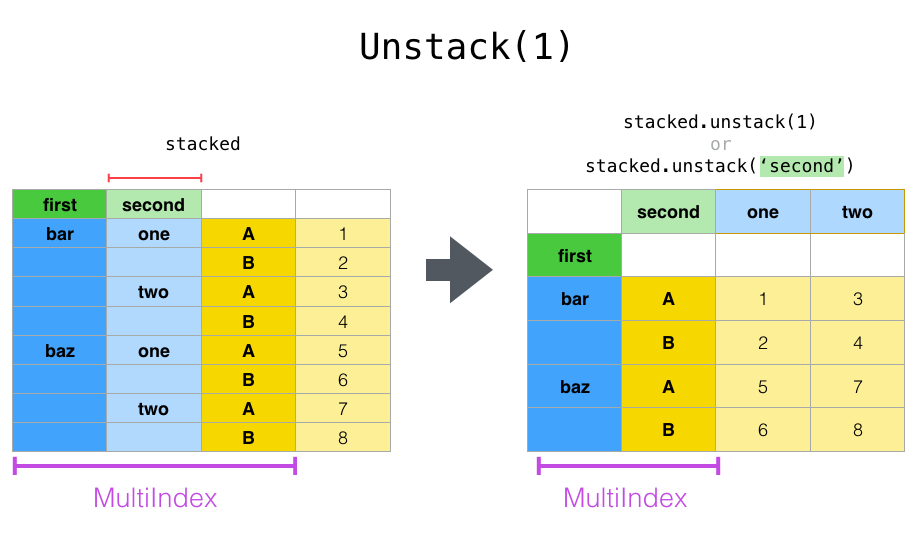
اگر فهرست ها دارای نام هستند ، می توانید به جای مشخص کردن شماره های سطح ، از نام سطح استفاده کنید:
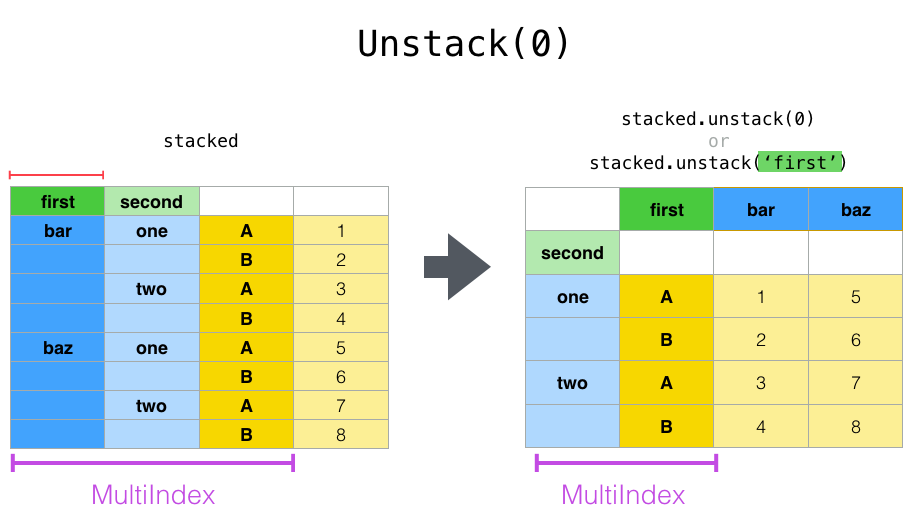
توجه کنید که روش های پشته () و unstack () به طور ضمنی سطح شاخص موجود را مرتب می کنند. از این رو یک تماس به پشته () و سپس Unstack () ، یا برعکس ، منجر به کپی مرتب شده از DataFrame اصلی یا سری می شود:
در صورت حذف تماس با sort_index () ، کد فوق یک TypeError را افزایش می دهد.
چند سطح#
شما همچنین ممکن است با عبور از لیستی از سطوح ، بیش از یک سطح را در یک زمان جمع کنید یا از بین ببرید ، در این صورت نتیجه نهایی به نظر می رسد که هر سطح در لیست به صورت جداگانه پردازش می شود.
لیست سطوح می تواند شامل نام های سطح یا شماره های سطح باشد (اما ترکیبی از این دو نیست).
داده های از دست رفته#
این توابع در مورد دست زدن به داده های گمشده هوشمند هستند و انتظار ندارند که هر زیر گروه در شاخص سلسله مراتبی دارای همان مجموعه برچسب ها باشد. آنها همچنین می توانند این شاخص را که بدون آن است ، کنترل کنند (اما شما می توانید با فراخوانی Sort_Index () ، آن را مرتب کنید. در اینجا یک مثال پیچیده تر است:
همانطور که در بالا ذکر شد ، پشته () را می توان با یک آرگومان سطح فراخوانی کرد تا کدام سطح را در ستون ها برای پشته انتخاب کند:
اگر زیر گروه ها مجموعه ای از برچسب ها را نداشته باشند ، می تواند به مقادیر گمشده منجر شود. به طور پیش فرض ، مقادیر گمشده با مقدار پیش فرض پر برای آن نوع داده جایگزین می شوند ، نان برای شناور ، NAT برای DateTimelike و غیره برای انواع عدد صحیح ، داده های پیش فرض به شناور تبدیل می شوند و مقادیر گمشده روی NAN تنظیم می شوند.
از طرف دیگر ، Unstack برای مشخص کردن مقدار داده های گمشده ، یک آرگومان Fill_Value اختیاری را می گیرد.
با MultiIndex#
هنگامی که ستون ها یک مولتی هستند نیز در مورد انجام کار درست دقت می کنند:
تغییر شکل توسط ذوب#
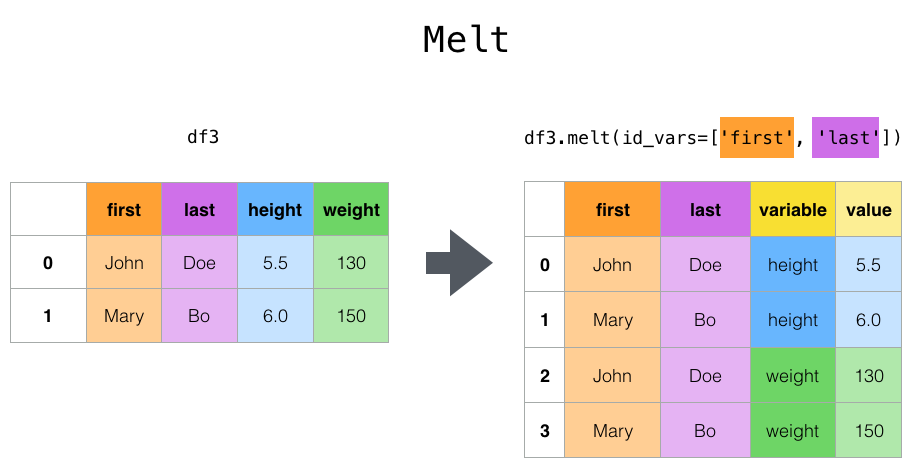
عملکرد ذوب () سطح بالا () و Dataframe مربوطه. MELT () برای ماساژ DataFrame به فرمی که یک یا چند ستون متغیرهای شناسه هستند ، مفید هستند ، در حالی که تمام ستون های دیگر ، متغیرهای اندازه گیری شده در نظر گرفته می شوند ، به ردیف "غیرقابل تغییر" هستندمحور ، فقط دو ستون غیر شناسایی کننده ، "متغیر" و "مقدار" را ترک می کند. نام آن ستون ها را می توان با تهیه پارامترهای VAR_NAME و VALUE_NAME سفارشی کرد.
هنگام تبدیل یک dataframe با استفاده از ذوب () ، این شاخص نادیده گرفته می شود. مقادیر اصلی شاخص را می توان با تنظیم پارامتر IGNORE_INDEX به FALSE نگه داشت (پیش فرض درست است). با این حال آنها را کپی می کند.
جدید در نسخه 1. 1. 0.
راه دیگر برای تبدیل استفاده از عملکرد راحتی داده پانل wide_to_long () است. انعطاف پذیر تر از ذوب () ، اما کاربر پسند تر است.
ترکیب با آمار و گروه#
این نباید شوک باشد که ترکیب Pivot () / Stack () / Unstack () با GroupBy و سری اصلی و عملکردهای آماری DataFrame می تواند برخی از داده های بسیار بیانگر و سریع داده ها را تولید کند.
جداول محوری#
در حالی که Pivot () هدف کلی را با انواع مختلف داده ها (رشته ها ، شماره ها و غیره) محوری فراهم می کند ، Pandas همچنین Pivot_Table () را برای محوری با تجمع داده های عددی فراهم می کند.
تابع Pivot_Table () می تواند برای ایجاد جداول محوری به سبک صفحه گسترده استفاده شود. برای برخی از استراتژی های پیشرفته به کتاب آشپزی مراجعه کنید.
تعدادی از استدلال ها طول می کشد:
داده ها: یک شیء DataFrame.
مقادیر: ستون یا لیستی از ستون ها برای جمع آوری.
فهرست: یک ستون ، grouper ، آرایه ای که دارای طول داده ها یا لیست آنها است. کلیدها برای گروه بندی در فهرست جدول محوری. اگر یک آرایه منتقل شود ، از آن به همان روش مقادیر ستون استفاده می شود.
ستون ها: یک ستون ، grouper ، آرایه ای که دارای طول داده ها یا لیست آنها است. کلیدها برای گروه بندی در ستون جدول محوری. اگر یک آرایه منتقل شود ، از آن به همان روش مقادیر ستون استفاده می شود.
Aggfunc: عملکردی برای استفاده برای جمع آوری ، پیش فرض به numpy. mean.
یک مجموعه داده مانند این را در نظر بگیرید:
ما می توانیم جداول محوری را از این داده ها به راحتی تولید کنیم:
هدف نتیجه یک DataFrame است که دارای شاخص های سلسله مراتبی بالقوه در ردیف ها و ستون ها است. اگر نام ستون مقادیر داده نشود ، جدول Pivot شامل تمام داده ها در سطح اضافی سلسله مراتب در ستون ها خواهد بود:
همچنین ، می توانید از Grouper برای کلمات کلیدی فهرست و ستون استفاده کنید. برای جزئیات بیشتر در مورد Grouper ، به گروه بندی با مشخصات Grouper مراجعه کنید.
در صورت تمایل می توانید با فراخوانی TO_STRING () مقادیر گمشده را حذف کنید و مقادیر گمشده را حذف کنید:
اضافه کردن حاشیه#
اگر حاشیه ها را به Pivot_Table () منتقل کنید ، همه ستون ها و ردیف های ویژه با جمع گروه های جزئی در دسته ها روی ردیف ها و ستون ها اضافه می شوند:
علاوه بر این ، می توانید با DataFrame. stack () تماس بگیرید تا یک DataFrame محوری را به عنوان داشتن یک فهرست چند سطحی نمایش دهید:
جدول بندی صلیب#
برای محاسبه یک اثر متقابل دو (یا بیشتر) از crosstab () استفاده کنید. به طور پیش فرض Crosstab () جدول فرکانس عوامل را محاسبه می کند مگر اینکه آرایه ای از مقادیر و یک عملکرد تجمع تصویب شود.
تعدادی از استدلال ها طول می کشد
فهرست: مقادیر آرایه مانند ، به گروه در ردیف ها.
ستون ها: مقادیر آرایه مانند ، به گروه در ستون ها.
مقادیر: آرایه ، اختیاری ، آرایه ای از مقادیر برای جمع آوری با توجه به عوامل.
Aggfunc: عملکرد ، اختیاری ، اگر هیچ آرایه ای از آن عبور نکند ، جدول فرکانس را محاسبه می کند.
Rownames: دنباله ، پیش فرض هیچ ، باید با تعداد آرایه های ردیف تصویب شده مطابقت داشته باشد.
COLNAMES: دنباله ، پیش فرض هیچ ، در صورت تصویب ، باید با تعداد آرایه های ستون منتقل شده مطابقت داشته باشد.
حاشیه ها: بولی ، پیش فرض کاذب ، اضافه کردن حاشیه ردیف/ستون (Subtotals)
عادی سازی: بولی ، ، یا ، پیش فرض نادرست. با تقسیم تمام مقادیر بر کل مقادیر ، عادی سازی کنید.
هر سری منتقل شده دارای ویژگی های نام خود است مگر اینکه نام ردیف یا ستون برای جدول بندی متقابل مشخص شود
اگر Crosstab () فقط دو سری دریافت کند ، جدول فرکانس را ارائه می دهد.
Crosstab () همچنین می تواند به داده های طبقه بندی شده پیاده سازی شود.
اگر می خواهید همه دسته بندی های داده را درج کنید ، حتی اگر داده های واقعی حاوی مواردی از یک دسته خاص نباشد ، باید dropna = false را تنظیم کنید.
عادی سازی#
جداول فرکانس همچنین می تواند عادی شود تا درصدها به جای شمارش با استفاده از آرگومان عادی ، درصدی را نشان دهد:
عادی سازی همچنین می تواند مقادیر موجود در هر سطر یا در هر ستون را عادی کند:
Crosstab () همچنین می تواند یک سری سوم و یک تابع تجمع (AGGFUNC) منتقل شود که برای مقادیر سری سوم در هر گروه که توسط دو سری اول تعریف شده است ، اعمال می شود:
اضافه کردن حاشیه#
سرانجام ، می توان حاشیه ها را نیز اضافه کرد یا این خروجی را عادی کرد.
کاشی کاری#
عملکرد برش () گروه بندی ها را برای مقادیر آرایه ورودی محاسبه می کند و اغلب برای تبدیل متغیرهای مداوم به متغیرهای گسسته یا طبقه بندی شده استفاده می شود:
اگر کلمه کلیدی سطل یک عدد صحیح باشد ، سطل های با عرض برابر تشکیل می شوند. از طرف دیگر می توانیم سطل های سفارشی را مشخص کنیم:
اگر کلمه کلیدی سطل ها یک فاصله زمانی باشد ، از این موارد برای سطل داده های منتقل شده استفاده می شود.
نشانگر محاسبات / متغیرهای ساختگی#
برای تبدیل یک متغیر طبقه بندی شده به یک داده "ساختار" یا "نشانگر" ، به عنوان مثال یک ستون در یک DataFrame (یک سری) که دارای مقادیر متمایز K است ، می تواند یک داده داده حاوی ستون های K از 1 و 0 را با استفاده از get_dummies () استخراج کند::
گاهی اوقات برای پیشوند نام ستون ، به عنوان مثال هنگام ادغام نتیجه با DataFrame اصلی مفید است:
این عملکرد اغلب همراه با توابع گسسته سازی مانند برش () استفاده می شود:
get_dummies () همچنین یک DataFrame را می پذیرد. به طور پیش فرض همه متغیرهای طبقه بندی شده (به معنای آماری ، طبقه بندی شده با DTYPE شیء یا طبقه بندی شده) به عنوان متغیرهای ساختگی رمزگذاری می شوند.
تمام ستون های غیر شیطان در خروجی دست نخورده گنجانده شده اند. می توانید ستون هایی را که با کلمه کلیدی ستون رمزگذاری شده اند ، کنترل کنید.
توجه کنید که ستون B هنوز در خروجی گنجانده شده است ، فقط رمزگذاری نشده است. اگر نمی خواهید آن را در خروجی قرار دهید ، می توانید قبل از تماس با get_dummies را رها کنید.
همانطور که با نسخه سری ، می توانید مقادیر پیشوند و پیشوند_سپ را منتقل کنید. به طور پیش فرض از نام ستون به عنوان پیشوند استفاده می شود ، و _ به عنوان جداکننده پیشوند. شما می توانید پیشوند و پیشوند را به 3 روش مشخص کنید:
رشته: برای رمزگذاری هر ستون از همان مقدار برای پیشوند یا prefix_sep استفاده کنید.
لیست: باید به همان طول تعداد ستون های رمزگذاری شده باشد.
DICT: نقشه برداری از نام ستون به پیشوند.
بعضی اوقات مفید خواهد بود که فقط سطح K-1 از یک متغیر طبقه بندی شده را حفظ کنید تا در هنگام تغذیه نتیجه به مدلهای آماری از همبستگی جلوگیری شود. می توانید با روشن کردن drop_first به این حالت تغییر دهید.
هنگامی که یک ستون فقط یک سطح دارد ، در نتیجه حذف می شود.
به طور پیش فرض ستون های جدید دارای np. uint8 dtype هستند. برای انتخاب یک dtype دیگر ، از آرگومان dtype استفاده کنید:
جدید در نسخه 1. 5. 0.
برای تبدیل یک داده "ساختار" یا "شاخص" ، به یک DataFrame طبقه بندی شده ، به عنوان مثال ستونهای K یک DataFrame حاوی 1s و 0 می توانند یک داده داده را بدست آورند که دارای مقادیر متمایز K با استفاده از_dummies () است:
داده های کدگذاری شده ساختگی فقط به دسته های K - 1 نیاز دارند ، در این حالت دسته k th یک دسته پیش فرض است ، که دلالت بر عدم تعیین هیچ یک از دسته های دیگر K - 1 دارد ، می توانند از طریق پیش فرض_کاتور منتقل شوند.
مقادیر فاکتور#
برای رمزگذاری مقادیر 1-D به عنوان یک نوع شمارش شده استفاده از فاکتور ():
توجه داشته باشید که فاکتور () شبیه به numpy. unique است ، اما در رسیدگی به NAN متفاوت است:
numpy. unique زیر به دلیل اشکال سفارش در زیر پایتون 3 با یک نوع. همچنین اینجا را ببینید.
اگر فقط می خواهید یک ستون را به عنوان یک متغیر طبقه بندی (مانند فاکتور R) اداره کنید ، می توانید از df ["cat_col"] = pd. categorical (df ["col"]) یا df ["cat_col"] = df ["استفاده کنید. col "]. Astype (" دسته "). برای اسناد کامل در مورد طبقه بندی ، به مقدمه طبقه بندی و مستندات API مراجعه کنید.
مثال ها#
در این بخش ، سؤالات و مثال های متداول را مرور خواهیم کرد. نام ستون و مقادیر ستون مربوطه نامگذاری شده است تا با چگونگی محور این DataFrame در پاسخ های زیر محور باشد.
محوری با تجمع واحد#
فرض کنید ما می خواستیم DF را محوری کنیم به گونه ای که مقادیر COL ستون ها هستند ، مقادیر ردیف شاخص هستند و میانگین Val0 مقادیر هستند؟به طور خاص ، DataFrame حاصل باید به نظر برسد:
این راه حل از Pivot_Table () استفاده می کند. همچنین توجه داشته باشید که Aggfunc = "میانگین" پیش فرض است. در اینجا گنجانده شده است تا صریح باشد.
توجه داشته باشید که می توانیم با استفاده از پارامتر Fill_Value مقادیر گمشده را جایگزین کنیم.
همچنین توجه داشته باشید که ما می توانیم در سایر توابع تجمیع نیز عبور کنیم. به عنوان مثال ، ما همچنین می توانیم به طور خلاصه عبور کنیم.
تجمع دیگری که می توانیم انجام دهیم محاسبه فرکانس است که در آن ستون ها و ردیف ها با هم اتفاق می افتند. برای انجام این کار ، می توانیم اندازه را به پارامتر Aggfunc منتقل کنیم.
محوری با تجمع های متعدد#
ما همچنین می توانیم چندین تجمع را انجام دهیم. به عنوان مثال ، برای انجام یک مبلغ و میانگین ، می توانیم لیستی را به استدلال Aggfunc منتقل کنیم.
توجه داشته باشید برای جمع آوری بیش از ستون های چند ارزش ، می توانیم در یک لیست به پارامتر مقادیر منتقل شویم.
توجه داشته باشید برای تقسیم بیش از چندین ستون می توانیم در یک لیست به پارامتر ستون ها منتقل شویم.
منفجر شدن یک ستون مانند لیست#
جدید در نسخه 0. 25. 0.
بعضی اوقات مقادیر موجود در یک ستون مانند لیست هستند.
ما می توانیم ستون مقادیر را منفجر کنیم و هر لیست مانند را به یک ردیف جداگانه تبدیل کنیم ، با استفاده از انفجار (). این مقادیر شاخص را از ردیف اصلی تکرار می کند:
همچنین می توانید ستون را در DataFrame منفجر کنید.
Series. Explode () لیست های خالی را با NP. NAN جایگزین می کند و ورودی های مقیاس را حفظ می کند. dtype از سری حاصل همیشه شیء است.
در اینجا یک usecase معمولی وجود دارد. شما رشته های جدا شده کاما را در یک ستون دارید و می خواهید این موضوع را گسترش دهید.
ایجاد یک شکل طولانی DataFrame اکنون با استفاده از عملیات منفجر و زنجیر شده ساده است
کسب درآمد از فارکس...
ما را در سایت کسب درآمد از فارکس دنبال می کنید
برچسب :
نویسنده : عسلی سهیال
بازدید : <-PostHit->
خبرنامه
